第I部 · Nanite
1Nanite:問題設定
従来のエンジンは、メッシュをハードウェアのドローコールで描き、アーティストが用意した数段階の詳細度(LOD)のうち一つをオブジェクト全体に適用する。素材が映画並みの密度(岩一つに数百万三角形、その岩が数千個)に達すると、この設計は三つの点で破綻する。
オブジェクト単位の LOD は粗すぎる。 根元がカメラから2 m、頂上が400 m離れた崖は、両端でまったく異なる詳細度を必要とする。
小さな三角形はハードウェアにとって無駄が多い。 GPU は ピクセルのクアッド単位でラスタライズするため、1ピクセルしか覆わない三角形でも4ピクセル分の費用を払う。ピクセルシェーディングよりはるか手前で、固定機能のセットアップ速度がボトルネックになる。
メモリ。 映画品質の素材は、一度にすべて VRAM に載らない。
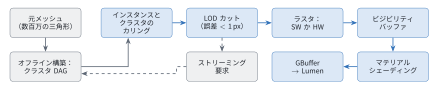
2クラスタ DAG の構築(オフライン)
クラスタ
元のメッシュは、三角形の隣接グラフにグラフ分割器(METIS)をかけることで、最大128三角形からなるクラスタに分割される。クラスタは空間的にまとまり、境界の辺をなるべく共有しないように作られる。クラスタは Nanite の原子であり、カリング、LOD 選択、ストリーミング、ラスタライズはすべてクラスタ単位で行われる。128三角形という大きさは、細かいカリングができる程度に小さく、クラスタごとの処理を償却し GPU のワークグループにうまく対応する程度に大きい。
グループ化、簡略化、再分割
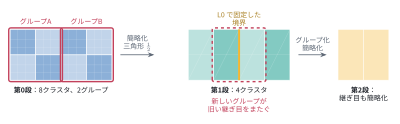
各クラスタを独立に簡略化して LOD を作るという素朴な方法は、すぐに破綻する。隣り合う二つのクラスタが異なる LOD になると辺が一致しなくなり、間に亀裂が生じるからだ。簡略化の際にクラスタ境界を固定すれば亀裂は防げるが、今度はその境界の辺が永遠に簡略化されず、数段階もするとメッシュは境界だらけになる。
Nanite の答えは、システム全体の核となる次の手法である。
隣接するクラスタ(典型的には8〜32個。概念上の最小は4個程度)を、共有辺を最小にするグラフ分割でクラスタグループにまとめる。
各グループの三角形を結合し、二次誤差計量(QEM)で三角形数が半分になるまで簡略化する。このとき固定するのはグループの外周だけであり、旧クラスタ間の内部の辺は消える。
簡略化したパッチを、再び128三角形のクラスタに再分割する。
新しいクラスタに対して同じ手順を繰り返す。次のグループ分けは改めて計算されるため、この段で固定された境界は次の段ではグループの内部に入り、そこで簡略化される。
結果が木ではなく DAG になる理由
第段のクラスタは第段のクラスタグループ全体の三角形から作られるので、複数の「子」をもつ。また簡略化されたグループは複数のクラスタに再分割されるので、第段の各クラスタは複数の親に寄与する。したがって階層は有向非巡回グラフ(DAG)となる。構造上もっとも重要な事実は、あるグループのクラスタ群と、そのグループから作られたクラスタ群は、まったく同じ境界をもつまったく同じ曲面を覆うということである。一方を他方に置き換えても、常に隙間は生じない。LOD はグループ単位で決まり、これによって隣接する領域が亀裂なしに異なる詳細度をとれる。
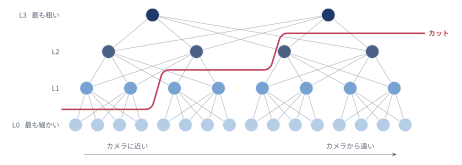
3カットの選択:視点依存の LOD
誤差の尺度
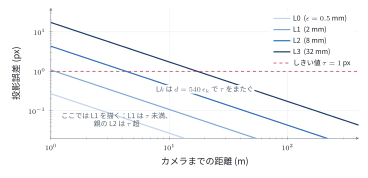
簡略化の各段は、オブジェクト空間での幾何誤差 (簡略化の二次誤差から得る)を記録する。各クラスタ について、Nanite は自身の誤差 とバウンディング球を保持し、さらに自身が簡略化されてできたグループ、つまり親の誤差 と境界も保持する。実行時には誤差を画面に投影する。中心 、視点からの距離 、垂直視野角 、高さ ピクセルのビューポートに対して、 (実装では、バウンディング球のもっとも近い点を用い、インスタンスのスケールも考慮する。)
並列な選択規則
GPU 上で DAG を上から順に辿るのは扱いにくい。そこで Nanite は、すべてのクラスタについて独立に判定を下す。 「自分は十分に精密で、親はそうではない」。これは、投影誤差が DAG に沿って単調であるならば、ちょうど一つの整合したカットを与える。つまり、どの視点から見ても親は子と同じかそれ以上に誤差が大きく見えなければならない。Nanite は構築時に、各グループに保存する誤差を子の誤差の最大値とし、そのバウンディング球が子の球を包むようにすることで、これを保証する。すると、どの視点についても根から葉へのすべての経路上で誤差が をまたぐ段がちょうど一つ存在し、あるグループのクラスタはすべて共通の親について同じ判定を下し、カットは隙間なく閉じる。
階層的カリング
毎フレーム、シーン内の全クラスタを判定するのでは、それでも数百万回の判定になる。クラスタグループはバウンディングボリューム階層(子を4〜8個もつ幅の広い BVH)に格納される。走査では、境界が視錐台の外にある場合、遮蔽されている場合、またはその下のすべてのクラスタがすでに細かすぎる場合(そのノードでの親誤差が 未満なので、下にカットはありえない)に、部分木ごと捨てる。走査はグローバルな作業キューをもつ単一の常駐型コンピュートディスパッチとして実行されるため、木の段ごとにディスパッチを発行する必要がない。
42パスのオクルージョンカリング
Nanite は階層 Z バッファ(HZB)に対してカリングを行う。HZB は深度バッファのミップピラミッドで、各テクセルはその下にあるもっとも遠い深度を保持する。クラスタの画面上の矩形は、それがおよそ テクセルを覆うミップ段で判定され、もっとも近い深度が保存された最遠深度より奥にあれば隠れていると判断される。
難しいのは、現在のフレームの深度は、そのフレームを描き終えるまで存在しないという点である。Nanite は、この鶏と卵の問題を2パスで解決する。
- 入力:前フレームの HZBprev、前フレームで可視だったインスタンスとクラスタの集合 Vprev
- パス1 推測:見えていたものは引き続き見える
- Vprev の各ノードについて:
- 視錐台内かつ HZBprev(再投影)で遮蔽されていなければ、ラスタライズ
- いま描いた深度から HZBcur を構築
- パス2 推測が外れたものをすべて拾う
- パス1で描かれなかった各ノードについて:
- 視錐台内かつ HZBcur で遮蔽されていなければ、ラスタライズして可視と記録
- HZBcur を再構築し、次フレームのために Vcur を保存
連続するフレームには一貫性があるので、パス1だけで大半を安く正しく描ける。パス2が正しさを保証する。新たに見えるようになったものは、このフレームにとって保守的な深度バッファ(いま本当に見えているものだけを含む)に対して判定されるので、見えるものが誤って捨てられることはない。代償は、HZB の構築が1回増えることと、通常はごく小さい2回目の走査である。
5ラスタライズ:微小三角形にはソフトウェアを
1ピクセル1三角形ではハードウェアが不向きな理由
固定機能のラスタライザは、数十から数百ピクセルを覆う三角形のために作られている。セットアップの費用は三角形ごとに一度払い、その後 のクアッドで多くのピクセルを埋める。三角形が1ピクセル程度になると、セットアップのスループットとクアッドの過剰シェーディングが支配的になる。Nanite のコンピュートシェーダ製ラスタライザは、微小三角形についてハードウェア経路のおよそ3倍速いと計測されている。
振り分け
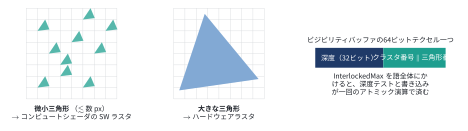
可視クラスタは、その三角形の画面上の大きさで振り分けられる。小さな三角形のクラスタはコンピュートシェーダのソフトウェアラスタライザへ送られ(三角形ごとに1スレッドで、小さなバウンディングボックス内を走査線またはエッジ関数で反復する)、大きな三角形のクラスタは、まだそちらが速いハードウェアラスタライザへ送られる。
GBuffer ではなくビジビリティバッファ
どちらのラスタライザも何もシェーディングしない。書き込むのはビジビリティバッファであり、ピクセルごとに64ビットの語の上位ビットに深度を、下位ビットに(可視クラスタ番号、三角形番号)を入れる。深度が最上位ビットを占めるので、64ビットのアトミック最大値演算一回(リバース Z では近いほど大きい)で深度テストと書き込みが同時に済む。これが、固定機能の ROP なしに、競合も起こさずにコンピュートシェーダでラスタライズできる理由である。
遅延マテリアル
シェーディングはその後、ピクセルごとに一度だけ行われる。三角形番号からマテリアルパスが三頂点を取り出し、そのピクセルについて重心座標と解析的な微分を再計算し、属性を補間してマテリアルシェーダを実行し、標準的な GBuffer に書き込む。レンダラの残り(と Lumen)はそれを使う。初期の UE5 実装ではマテリアルごとに全画面パスを1回描き、マテリアル ID の深度テストで各パスが自分のピクセルだけに触れるようにしていた。後のバージョンでは、ピクセルをマテリアル別にビン分けしてコンピュートでシェーディングする。帰結は二つある。オーバードローの費用は64ビットのアトミック演算だけで、マテリアル評価は決して重複しない。そして、画面に見えている異なるマテリアルの数に応じてフレームごとのオーバーヘッドが増える。
6ストリーミング、圧縮、そして残された課題
仮想化ジオメトリ
仮想テクスチャと同様に、Nanite は現在のビューが必要とするものだけを保持する。クラスタグループは固定サイズ(128 KB)のページに詰められる。もっとも粗い段からなる少数のルートページは常駐しているので、どのメッシュも常に何かは描ける。カリング中に、カットが非常駐のクラスタを必要とすると GPU が要求を書き込み、CPU が優先度順にページを読み込み、カットは数フレームかけて細かくなる。DAG 構造により、常駐しているより粗い祖先が必ず代役を務められる。
圧縮
位置はメッシュごとの格子に量子化され、クラスタの境界に対する相対値として、クラスタごとのビット幅で格納される。法線は八面体符号化を用い、インデックスはクラスタ内の頂点集合に対する局所値として格納される。メモリ上の形式は GPU で直接復号でき、ディスク上の形式は汎用圧縮器(Oodle)がさらに縮められるバイト指向の配置を加える。公表値では、Nanite メッシュはディスク上で入力三角形あたり約14バイトであり、LOD 一式をもつ通常の非 Nanite メッシュより小さい。
限界とその後の拡張
集合的なジオメトリ。 Nanite が簡略化するのは曲面である。草、葉、髪は多数の離れた薄い断片であり、簡略化すると体積がやせ、自己遮蔽によるカリングもきかない。フォリッジ対応は段階的に進んだ(マスクマテリアル、プログラマブルラスタ、そして 5.7 ではインスタンス化したアセンブリ、スキニングによる変形、遠景の樹冠向けのボクセル的表現を加えた実験的なフォリッジ経路)。
変形。 当初は静的メッシュのみだったが、スケルタルメッシュ、World Position Offset、ディスプレイスメントによるテッセレーションが 5.x の各版で追加された。
カットでの面のちらつき。 LOD はグループ単位で切り替わるため、移動に伴ってトポロジーがわずかに変わることがある。 ピクセルでは通常見えないが、刻まれた文字のような鋭い細部はちらつくことがある。
影。 従来のシャドウマップではマイクロジオメトリを解像できないため、Nanite は仮想シャドウマップ(同じ Nanite パイプラインで描かれる 16k の仮想シャドウマップ)と組み合わされる。
第II部 · Lumen
7Lumen:問題設定
グローバルイルミネーションとは、直接光の項だけでなくレンダリング方程式そのものを解くことである。 の中の再帰が光を反射させる。オフラインレンダラは、ピクセルあたり数百本のレイでこの積分をモンテカルロ推定する。1440p・60 fps のゲームが払えるのは、ピクセルあたりおそらく半本のレイであり、しかも相手は完全に動的な世界(焼き込みライトマップなし)で、レイトレーシング用の構造に全詳細で入れるには密すぎる Nanite ジオメトリでできている。
8レイのためのシーン表現
メッシュ距離場
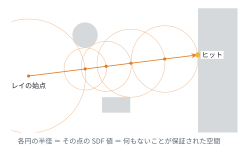
各メッシュには事前計算された符号付き距離場(SDF)がある。これは疎な3次元格子で、各テクセルにはもっとも近い曲面までの距離(内部では負)が入っている。SDF のレイマーチングはスフィアトレーシングである。現在の点で保存されている距離は、その半径の内側には何もぶつからないことを保証する半径なので、レイはその分だけ安全に進める。 開けた空間では歩幅が大きく、曲面の近くでは小さくなる。SDF はさらに、ソフトシャドウとコーンの推定をほぼ無料で与える。レイが幾何に最接近した度合い は、レイ周りのコーンがどれだけ遮られているかの近似になるからだ。
グローバル距離場
重なり合う多数のメッシュ SDF をレイごとに辿るのは、距離とともに高くつく。Lumen はさらに、すべてのメッシュ SDF をグローバル距離場に統合する。これはカメラ中心のクリップマップの集合(外側ほど解像度の粗い入れ子の立方体)で、物体が動くと少しずつ更新される。安価で遠くまで届くが、解像度が低く薄い形状を失う。そのため Lumen は、レイの最初の数メートルには精密なメッシュ SDF を使い、その先でグローバル距離場に切り替える。
サーフェスキャッシュ
距離場のヒットは、レイがどこで止まったかは教えてくれるが、そこでの光の色は教えてくれない。任意のヒット点でマテリアルの完全なシェーディングと直接光を評価していては遅すぎる。Lumen の答えがサーフェスキャッシュである。
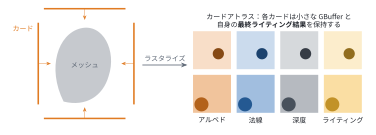
各メッシュは少数のカードで覆われる。カードはメッシュの周りに置かれた向きをもつ矩形である(概念的には、最大6方向からメッシュを見る正射影カメラのようなもの。複雑なメッシュには構築時の配置処理でより多くのカードが割り当てられる)。
各カードは(Nanite で、したがって安価に)アトラスへラスタライズされ、アルベド、法線、放射、不透明度、深度が格納される。カードの解像度はカメラからの距離に従い、フレームごとの予算内で更新される。
そのうえでライティングはカード空間で計算される。影付きの直接光に加え、カードのテクセル自体から短いレイを飛ばして集めた間接光である。
キャッシュ内のラジオシティ:無限反射をただで
サーフェスキャッシュが自身のテクセルの間接光を計算するとき、そのレイはサーフェスキャッシュ自体に当たり、前フレームのライティング結果を読む。1フレームに1回の反射が数フレームで多重反射の光に蓄積される。これは時間方向に回すレンダリング方程式の不動点反復である。 ここで は1回反射の輸送作用素である。物理的なアルベドでは のノルムは1未満なので、反復は多重反射の完全な解に収束する。更新は償却される。距離と最近の変化で優先順位を付け、フレームごとに予算内の一部のカードだけを再ライティングする。照明を点けたとき、Lumen の間接光が一拍遅れて目に見えて「落ち着く」のはこのためである。
9最終ギャザー:スクリーンプローブ
なぜプローブか
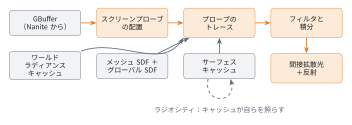
ピクセルあたり1本のレイを飛ばしてデノイズしても、拡散 GI にはノイズが多すぎる。Lumen は、拡散の間接光が低周波であることを利用する。スクリーンプローブを疎に配置し(既定では ピクセルのタイルごとに一つ、深度や法線が急に変わるところには追加で配置)、各プローブから半球全体をトレースし、ピクセルごとにプローブ間を補間する。
プローブが保持するもの
各プローブは、半球にわたる入射ラディアンスを八面体マップ(球を正方形に展開したもの)に格納する。典型的には 方向である。プローブあたり64本のレイを256ピクセルに一つのプローブで飛ばせば 本/ピクセルだが、各ピクセルは近隣プローブを補間し、プローブは時間方向にも再利用されるので、実質的にははるかに多くの方向について積分していることになる。
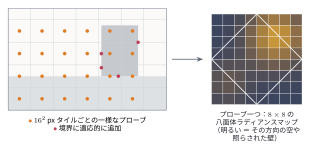
プローブレイの重点サンプリング
プローブの64本のレイはどこへ向けるべきか。一様な方向では、半球の暗い部分にレイを浪費する。Lumen は、すでに分かっている二つの項からサンプリングの確率密度(PDF)を作る。プローブを使うピクセルの BRDF と法線、そしてプローブ自身の前フレームのラディアンス(再投影したもの)である。明るかった方向や BRDF が重く重み付けする方向にはより多くのレイが向かい、その PDF で割ることでモンテカルロ推定は不偏に保たれる。 これはオフラインで使われる積の重点サンプリングと同じ発想であり、ピクセルごとではなくプローブごとに行うことで費用を抑えている。
フィルタリングと積分
プローブのラディアンスは近隣のプローブ間で空間的にフィルタリングされ(深度や法線が食い違う近隣、レイが遮られていたはずの近隣は除く)、補間しやすい小さな形式(拡散には低次の球面調和関数)に変換され、各ピクセルが平面距離による重みで近くのプローブを補間する。最後に時間フィルタが複数フレームにわたって蓄積する。
10トレースのはしご
各プローブレイは、次第に粗くなるが次第に遠くまで届く手法の列に沿ってトレースされる。各段は前の段があきらめたところから引き継ぐ。
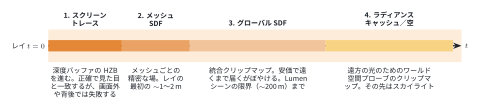
1. スクリーントレース
現在の深度バッファの HZB の中をレイで進む。画面上の何かに当たれば、そこにある前フレームの最終ライティング結果を読む。実際に描画されたジオメトリ(Nanite の詳細を含む)と一致し、粗い代理表現が取りこぼす小さな接触反射も拾えるので、これがもっとも正確な情報源である。
2〜3. 距離場トレース
スクリーントレースが画面外に出たり曲面の背後を通ったりしたら、止まったところからメッシュ SDF、次いでグローバル SDF を通して続け、ヒットはサーフェスキャッシュの参照でシェーディングする。
4. ラディアンスキャッシュ
長いレイは、もっとも高価でありながら一本一本の重要度はもっとも低い。Lumen は第二のワールド空間のプローブ群を保持する。カメラ中心のクリップマップ上の疎なプローブで、角度方向の解像度は高いがゆっくり更新され、すべてのスクリーンプローブから再利用される。一定距離を越えたスクリーンプローブのレイは、そこでトレースをやめてワールドのラディアンスキャッシュを参照する。小さく明るい遠方の特徴(暗い部屋の向こうの明るい窓)がノイズにならず安定するのはこのためである。
ハードウェアレイトレーシング・モード
RT 対応の GPU では、第2〜3段を、ハードウェア BVH を通じた実際の三角形へのレイトレーシングに置き換えられる。Nanite メッシュは簡略化したフォールバックメッシュとして BVH に入る(マイクロポリゴンの全詳細では大きすぎる)が、曲面の近くではスクリーントレースが全詳細を回復する。ヒットではサーフェスキャッシュを読む(速い)か、ヒット点でマテリアルとライティングを完全に評価する(「ヒットライティング」。遅いが、鏡のような反射には必要)かを選べる。ハードウェアモードは薄いジオメトリ、スキンメッシュ、正確な遮蔽をはるかにうまく扱い、ソフトウェアモードはどこでも動き、より多くのインスタンスにスケールする。最近の版(5.6、5.7)では、コンソールでの性能向上に伴い、既定の重心がハードウェア経路へ移りつつある。
11反射、半透明、その他
反射
粗い反射はローブの広い間接鏡面反射にすぎないので、スクリーンプローブのラディアンスを再利用する。より滑らかな面(ラフネスがしきい値未満)には、同じはしごを通して低解像度でピクセルごとに専用の反射レイを飛ばし、空間・時間方向にデノイズする。ハードウェアモードの鏡面反射はヒットライティングを使い、反射された物体が粗いサーフェスキャッシュの参照ではなく完全にシェーディングされるようにする。
半透明とフォグ
低解像度のフロクセル(視錐台に沿ったボクセル)ボリュームを、ボクセル中心から同じ構造へトレースしてライティングする。半透明の面とボリューメトリックフォグはそれをサンプリングする。
破綻する場所
SDF の解像度より薄い壁は光が漏れる。カードで覆いきれない形状(深いくぼみ)は間接光が欠けたり暗くなったりする。サーフェスキャッシュと時間フィルタは数フレームかけて収束するので、急な照明変化には遅れが出る。放射面はたまたま当たったレイでしか見つからず直接サンプリングされないため、放射面だけで照らす大きなシーンはノイズが多い。(5.5 で導入され 5.7 で拡張された MegaLights は、多数の光源からの直接光という別の問題を扱う。)
12二つはどう噛み合うか
| Nanite | Lumen | |
|---|---|---|
| 問題 | ジオメトリの費用がコンテンツ量に比例する | ライティングの費用がピクセルあたりのレイ数に比例する |
| 中心の手法 | クラスタ DAG と1ピクセル誤差のカット | 疎なプローブ、代理シーン、キャッシュ |
| 階層 | クラスタ DAG、グループ上の BVH | SDF クリップマップ、プローブのクリップマップ、HZB のミップ |
| 時間方向の再利用 | 前フレームの可視集合(パス1) | サーフェスキャッシュ、ラディアンスキャッシュ、時間フィルタ、重点サンプリングの PDF |
| 空間方向の再利用 | 一つのクラスタが多数のピクセルに | 一つのプローブが約256ピクセルに |
| GPU の使い方 | 常駐型コンピュート、64ビットアトミック | コンピュートでのプローブトレース、非同期更新 |
| 取り除くボトルネック | 三角形セットアップ、オーバードロー、VRAM | レイ数、ヒット点でのマテリアル評価 |
| 典型的なアーティファクト | まれな LOD のトポロジーのちらつき | 光漏れ、急な変化の後の遅れ |
依存関係は双方向である。Lumen は Nanite を必要とする。カードはメッシュをラスタライズして写し取るものであり、毎フレーム数千枚のカードを写せるのは Nanite がそれを安く描くからだ。Nanite は Lumen(またはそれに類するもの)を必要とする。映画並みの密度のジオメトリも、平板な環境光で照らせばプラスチックの模型に見える。細部を本物らしく見せるのは、Lumen が与える微小な遮蔽と反射光である。